Para quien decide
Un valor por periodo, con intervalo y variación: se lee en una reunión y resiste las preguntas.
AI Trust Score
Seis señales observadas en las respuestas de los asistentes de IA, en un valor de 0 a 100: cuánto te nombran, te recomiendan, citan tus fuentes, hablan bien de ti, te prefieren a la competencia y se mantienen coherentes. Lo calcula el código, nunca un modelo.
Por qué un número
Antes de elegir, un cliente puede preguntar a ChatGPT, Gemini, Perplexity, Copilot o Claude y leer una respuesta ya redactada. Menciones, recomendaciones, fuentes, tono y competidores se mueven juntos: seguirlos uno a uno es lento, presentarlos a quien decide es difícil.
La puntuación da al equipo una referencia compartida, con el método publicado y los detalles siempre a un clic. No sustituye las medidas: las ordena e indica qué señal trabajar primero.

Un valor por periodo, con intervalo y variación: se lee en una reunión y resiste las preguntas.
Las dimensiones que más pesan y las que frenan, con las respuestas que las componen.
Las fuentes citadas y las afirmaciones que aclarar, enlazadas con las Acciones.
Las seis dimensiones
Cada dimensión es una relación entre recuentos observados, de 0 a 100, con su muestra. Los pesos suman 100 y solo cambian con una nueva versión publicada del método.
La Autoridad de la versión 1 mide la presencia de tus fuentes entre las citadas; la calidad del tipo de fuente llegará con una versión posterior. La Preferencia compara las menciones por parejas: 50 significa empate, sea cual sea el número de competidores.
| Dimensión y peso | Qué observa | Sobre qué base |
|---|---|---|
| Visibilidad · 25 % | Con qué frecuencia te nombran las respuestas. | Respuestas completas y revisadas, media por pregunta y asistente. |
| Recomendaciones · 20 % | Con qué frecuencia te recomiendan para la necesidad de la pregunta. | Las mismas respuestas que la Visibilidad. |
| Autoridad · 15 % | Cuánto citan tus páginas las respuestas que exponen fuentes. | Solo las respuestas en las que la cita es evaluable. |
| Reputación · 15 % | El tono de las respuestas cuando te nombran. | Menciones positivas, neutras (contadas a la mitad) y negativas. |
| Preferencia · 15 % | Cómo te sitúas frente a cada competidor declarado. | Comparaciones por parejas en las mismas respuestas. |
| Coherencia · 10 % | Cuán estable se mantiene tu presencia entre asistentes y pruebas. | Solo donde apareces: la ausencia ya está en la Visibilidad. |
Cómo se calcula
El modelo de lenguaje lee una respuesta y la clasifica: si nombra la marca, si la recomienda, si cita una de sus páginas, con qué tono, junto a qué competidores. Un juez determinista verifica cada clasificación sobre el texto y una persona la revisa. La puntuación la calcula el código, solo a partir de esos recuentos.
El total es la suma de peso por valor de las dimensiones medidas, dividida por la suma de sus pesos. Mismos datos, mismo resultado, en cada máquina.
Las mismas preguntas, a los mismos asistentes, en cada ciclo.
Un extractor clasifica, un juez determinista controla, una persona revisa.
Cada dimensión con su numerador, su denominador y su peso.
Una media ponderada, siempre con cobertura e intervalo al 95 % al lado.
Muestra y cobertura
Una dimensión solo se mide con suficientes observaciones. Bajo el umbral queda excluida y declarada, con el motivo: no vale cero y no rebaja el total a escondidas.
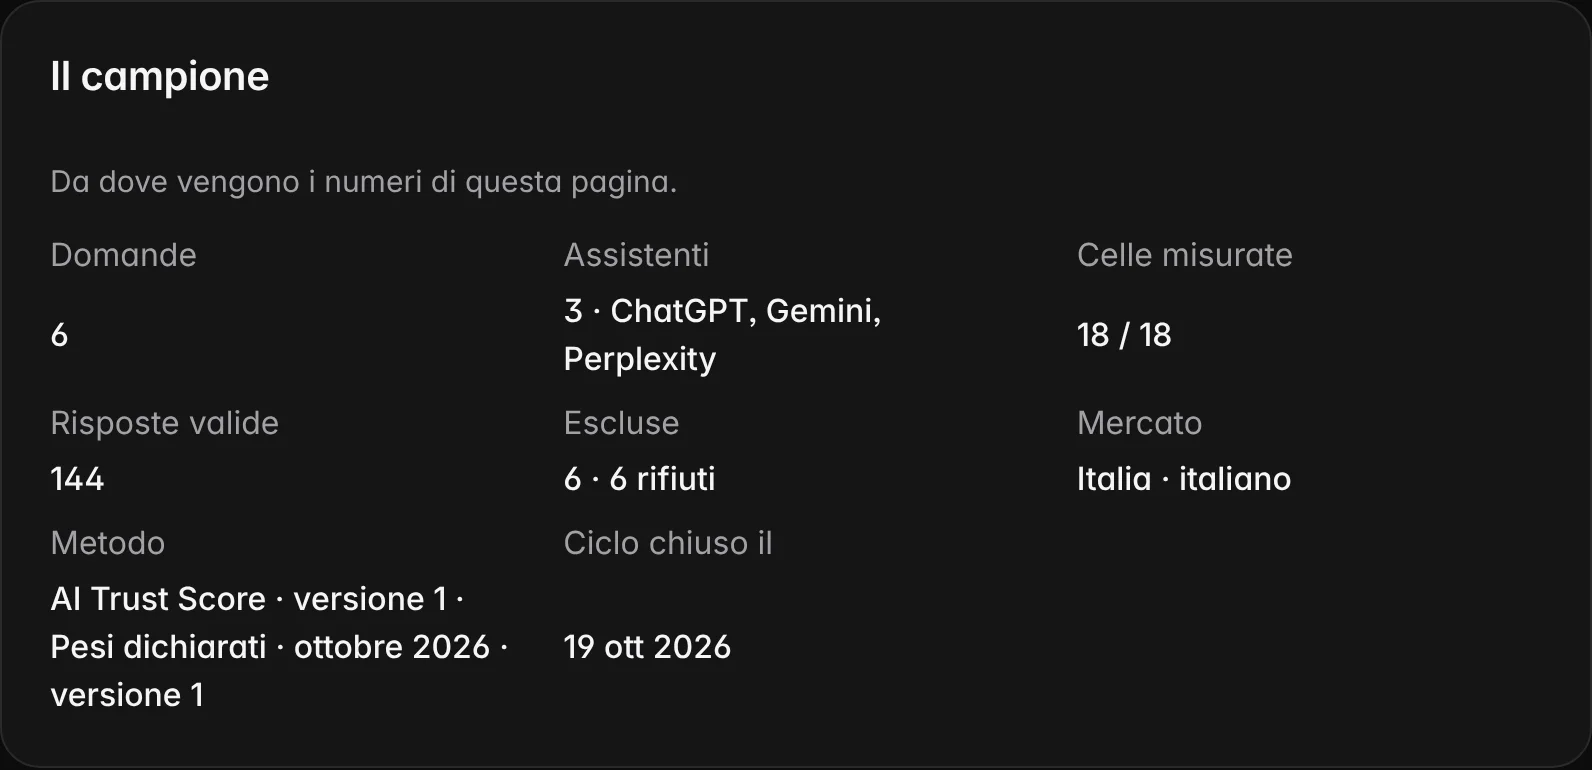
Por cada dimensión, más un mínimo de preguntas o de competidores: un solo caso no decide un valor.
La suma de los pesos medidos. El total solo aparece si la Visibilidad está medida y la cobertura llega al menos al 70 %.
Junto al valor, el intervalo que tendría el total si las dimensiones excluidas valieran 0 o 100.
Incertidumbre
Una puntuación sin intervalo promete una precisión que la muestra no tiene. Por eso junto al valor aparece siempre el intervalo de credibilidad al 95 %, con la precisión declarada.
El intervalo nace de 10.000 extracciones Monte Carlo con semilla fija, remuestreando preguntas y asistentes: el mismo panel da siempre el mismo intervalo. Si la semiamplitud supera 15 puntos, el valor se declara «por encima del umbral de precisión».
El mismo valor de ejemplo con dos muestras distintas: el intervalo estrecho se compara; el amplio se declara por encima del umbral de 15 puntos fijado por el método.
| Ejemplo inventado | Valor e intervalo al 95% | Cómo se lee |
|---|---|---|
| Panel amplio | 62, entre 58 y 66: semiamplitud de 4 puntos. | Precisión dentro del umbral: el valor entra en las comparaciones. |
| Panel reducido | 62, entre 44 y 80: semiamplitud de 18 puntos. | Por encima del umbral de 15 puntos: el valor se publica declarado como tal. |
| El mismo panel, otra vez | El mismo intervalo, en cada nuevo cálculo. | La semilla fija hace repetibles las extracciones Monte Carlo. |
Comparaciones en el tiempo
Cada puntuación lleva la huella del método que la produjo: versión, pesos, umbrales, estadística. Dos valores solo se ponen en fila con la misma huella; un cambio de método interrumpe la serie en lugar de inventar una variación.
La comparación dice cuánto ha cambiado la puntuación. Para atribuir un efecto hacen falta experimentos con un grupo de control.
El mismo cálculo sobre las respuestas de un solo asistente: bases más pequeñas, intervalos más amplios, declarados.
Las seis dimensiones de la competencia sobre las mismas preguntas, donde los datos lo permiten.
Del número a la acción
Las dimensiones que más contribuyen y las que menos pesan se leen en puntos, con su base. Desde ahí se abre la respuesta que las compone y se prepara la intervención adecuada: una página que aclarar, una fuente que conquistar, una FAQ que escribir.
Una lectura de ejemplo sobre una marca ficticia: la dimensión que sostiene la puntuación, la que la frena, la respuesta que abrir y la intervención que se deriva.
Qué no es
Es un indicador propio, con método publicado. Resume lo que las respuestas observadas dicen de ti, en un periodo, para un mercado y un idioma.
Observa las respuestas; lo que un modelo «piensa» no lo mide nadie.
Ni una previsión de ventas, ni una nota a sus productos.
Ningún valor procede de un modelo de lenguaje: solo recuentos revisados.
Preguntas frecuentes
Por qué el AI Trust Score usa seis dimensiones, qué mide realmente, por qué puede faltar una dimensión y en qué se diferencia del Índice de visibilidad.
Porque ser nombrado, ser recomendado, ser citado como fuente, el tono, la comparación con los competidores y la estabilidad cambian por motivos distintos. El valor de 0 a 100 las resume, y cada una sigue siendo legible con su base.
No. Nadie puede medir lo que «piensa» un modelo. La puntuación resume señales observables en las respuestas: menciones, recomendaciones, fuentes, tono, comparaciones y estabilidad.
No. Puedes trabajar en contenidos y fuentes y medir qué cambia, con el mismo método. Nadie puede prometer un aumento.
Porque no ha alcanzado la muestra mínima. Queda excluida y declarada; si la cobertura baja del 70 % de los pesos, el total no se calcula.
El Índice de visibilidad resume la presencia en cinco canales: IA, búsqueda, redes sociales, prensa y reputación. El AI Trust Score mira solo las respuestas de IA y lee en ellas seis dimensiones. Son dos métodos distintos, publicados por separado.
Los de tu panel, cualificados en el periodo y declarados junto al valor. Cada combinación de pregunta y asistente pesa lo mismo.
Rutas relacionadas
Cada función responde a una pregunta concreta. Desde aquí pasas a las funciones relacionadas, al método con que se miden y a la ayuda para usarlas en el trabajo diario.
Visibilidad en IA, AI Trust Score, búsqueda, reputación, competidores, acciones y ejecución: una función para cada pregunta sobre tu marca.
LeerTrustInsider en seis pasos: marca, preguntas, presupuesto, pruebas, intervención página por página y verificación con las mismas preguntas.
LeerCómo nace cada medición de TrustInsider: muestreo de las respuestas de IA, fuentes y derechos, cálculo de los índices y límites declarados.
LeerAyuda sobre acceso, créditos, recogidas, integraciones y datos: guías, FAQ, asistente del sitio y solicitudes de soporte desde el espacio.
Leer