Für Entscheider
Ein Wert pro Zeitraum, mit Intervall und Veränderung: lesbar im Meeting und belastbar bei Rückfragen.
AI Trust Score
Sechs Signale aus den Antworten von KI-Assistenten, in einem Wert von 0 bis 100: wie oft sie Sie nennen, empfehlen, Ihre Quellen zitieren, gut über Sie sprechen, Sie Wettbewerbern vorziehen und konsistent bleiben. Berechnet wird er vom Code, nie von einem Modell.
Warum eine Zahl
Vor einer Entscheidung kann ein Kunde ChatGPT, Gemini, Perplexity, Copilot oder Claude fragen und eine fertige Antwort lesen. Erwähnungen, Empfehlungen, Quellen, Tonalität und Wettbewerber bewegen sich gemeinsam: Sie einzeln zu verfolgen ist langsam, sie Entscheidern zu präsentieren schwierig.
Der Score gibt dem Team einen gemeinsamen Bezugspunkt, mit veröffentlichter Methode und den Details immer einen Klick entfernt. Er ersetzt die Messungen nicht: Er ordnet sie und zeigt, an welchem Signal zuerst gearbeitet werden sollte.

Ein Wert pro Zeitraum, mit Intervall und Veränderung: lesbar im Meeting und belastbar bei Rückfragen.
Die Dimensionen, die am meisten zählen, und jene, die bremsen, mit den Antworten dahinter.
Die zitierten Quellen und die zu klärenden Aussagen, verknüpft mit den Maßnahmen.
Die sechs Dimensionen
Jede Dimension ist ein Verhältnis beobachteter Zählungen, von 0 bis 100, mit eigener Stichprobe. Die Gewichte ergeben zusammen 100 und ändern sich nur mit einer neuen, veröffentlichten Methodenversion.
Autorität misst in Version 1 die Präsenz Ihrer Quellen unter den zitierten; die Qualität des Quellentyps kommt mit einer späteren Version. Präferenz vergleicht Erwähnungen paarweise: 50 bedeutet Gleichstand, unabhängig von der Zahl der Wettbewerber.
| Dimension und Gewicht | Was er beobachtet | Auf welcher Basis |
|---|---|---|
| Sichtbarkeit · 25 % | Wie oft die Antworten Sie nennen. | Vollständige, geprüfte Antworten, gemittelt nach Frage und Assistent. |
| Empfehlungen · 20 % | Wie oft sie Sie für das Anliegen der Frage empfehlen. | Dieselben Antworten wie bei der Sichtbarkeit. |
| Autorität · 15 % | Wie oft Antworten mit Quellen Ihre Seiten zitieren. | Nur Antworten, in denen das Zitat bewertbar ist. |
| Reputation · 15 % | Die Tonalität der Antworten, wenn sie Sie nennen. | Positive, neutrale (zur Hälfte gezählt) und negative Erwähnungen. |
| Präferenz · 15 % | Wo Sie gegenüber jedem angegebenen Wettbewerber stehen. | Paarweise Vergleiche in denselben Antworten. |
| Konsistenz · 10 % | Wie stabil Ihre Präsenz über Assistenten und Durchläufe bleibt. | Nur wo Sie vorkommen: Abwesenheit steckt schon in der Sichtbarkeit. |
Wie es berechnet wird
Das Sprachmodell liest eine Antwort und klassifiziert sie: Nennt sie die Marke, empfiehlt sie sie, zitiert sie eine ihrer Seiten, in welcher Tonalität, neben welchen Wettbewerbern. Ein deterministischer Prüfer kontrolliert jede Klassifizierung am Text, und ein Mensch prüft sie. Den Score berechnet der Code, allein aus diesen Zählungen.
Der Gesamtwert ist die Summe aus Gewicht mal Wert der gemessenen Dimensionen, geteilt durch die Summe ihrer Gewichte. Gleiche Daten, gleiches Ergebnis, auf jeder Maschine.
Dieselben Fragen an dieselben Assistenten, in jedem Zyklus.
Ein Extraktor klassifiziert, ein deterministischer Prüfer kontrolliert, ein Mensch prüft.
Jede Dimension mit Zähler, Nenner und Gewicht.
Ein gewichteter Durchschnitt, immer mit Abdeckung und 95-%-Intervall.
Stichprobe und Abdeckung
Eine Dimension wird nur mit genügend Beobachtungen gemessen. Unter der Schwelle bleibt sie ausgeschlossen und mit Grund ausgewiesen: Sie zählt nicht als null und senkt den Gesamtwert nicht heimlich.
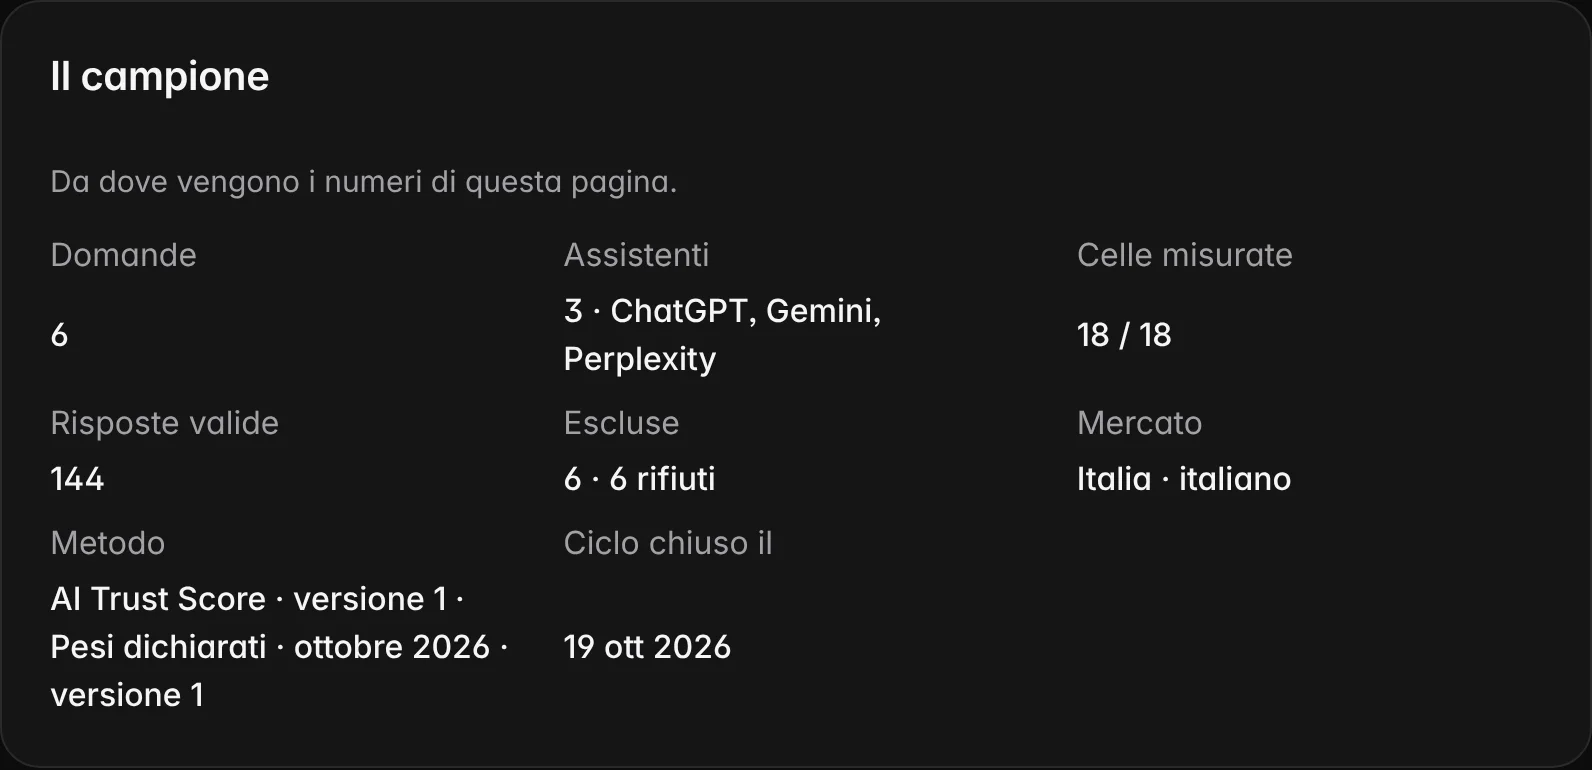
Für jede Dimension, dazu eine Mindestzahl an Fragen oder Wettbewerbern: Ein einzelner Fall entscheidet keinen Wert.
Die Summe der gemessenen Gewichte. Der Gesamtwert erscheint nur, wenn die Sichtbarkeit gemessen ist und die Abdeckung mindestens 70 % erreicht.
Neben dem Wert der Bereich, den der Gesamtwert hätte, wenn die ausgeschlossenen Dimensionen 0 oder 100 wären.
Unsicherheit
Ein Score ohne Intervall verspricht eine Genauigkeit, die die Stichprobe nicht hat. Deshalb steht neben dem Wert immer das 95-%-Glaubwürdigkeitsintervall, mit ausgewiesener Genauigkeit.
Das Intervall entsteht aus 10.000 Monte-Carlo-Ziehungen mit festem Seed, bei denen Fragen und Assistenten neu gezogen werden: Dasselbe Panel ergibt immer dasselbe Intervall. Liegt die halbe Breite über 15 Punkten, wird der Wert als „jenseits der Genauigkeitsschwelle“ ausgewiesen.
Derselbe Beispielwert mit zwei verschiedenen Stichproben: Das enge Intervall wird verglichen, das breite wird als über der von der Methode festgelegten Schwelle von 15 Punkten ausgewiesen.
| Erfundenes Beispiel | Wert und 95%-Intervall | Wie man es liest |
|---|---|---|
| Großer Fragenkatalog | 62, zwischen 58 und 66: halbe Breite von 4 Punkten. | Präzision innerhalb der Schwelle: Der Wert geht in die Vergleiche ein. |
| Kleiner Fragenkatalog | 62, zwischen 44 und 80: halbe Breite von 18 Punkten. | Über der Schwelle von 15 Punkten: Der Wert wird als solcher ausgewiesen. |
| Derselbe Fragenkatalog, erneut | Dasselbe Intervall, bei jeder neuen Berechnung. | Der feste Seed macht die Monte-Carlo-Ziehungen wiederholbar. |
Vergleich im Zeitverlauf
Jeder Score trägt den Fingerabdruck der Methode, die ihn erzeugt hat: Version, Gewichte, Schwellen, Statistik. Zwei Werte werden nur bei gleichem Fingerabdruck aneinandergereiht; ein Methodenwechsel unterbricht die Reihe, statt eine Veränderung zu erfinden.
Der Vergleich sagt, wie stark sich der Score verändert hat. Um eine Wirkung zuzuschreiben, braucht es Experimente mit Kontrollgruppe.
Dieselbe Berechnung auf den Antworten eines einzelnen Assistenten: kleinere Basen, breitere Intervalle, ausgewiesen.
Die sechs Dimensionen der Wettbewerber bei denselben Fragen, soweit die Daten es erlauben.
Von der Zahl zur Maßnahme
Die Dimensionen mit dem größten und dem geringsten Beitrag werden in Punkten gelesen, mit ihrer Basis. Von dort öffnen Sie die Antwort dahinter und bereiten die passende Maßnahme vor: eine Seite klären, eine Quelle gewinnen, eine FAQ schreiben.
Eine Beispielauswertung zu einer fiktiven Marke: die Dimension, die den Score stützt, die, die ihn bremst, die zu öffnende Antwort und die Maßnahme, die daraus folgt.
Was er nicht ist
Es ist ein eigener Indikator mit veröffentlichter Methode. Er fasst zusammen, was die beobachteten Antworten über Sie sagen, in einem Zeitraum, für einen Markt und eine Sprache.
Er beobachtet Antworten; was ein Modell „denkt“, misst niemand.
Weder eine Absatzprognose noch eine Note für seine Produkte.
Kein Wert stammt aus einem Sprachmodell: nur geprüfte Zählungen.
Häufige Fragen
Warum der AI Trust Score sechs Dimensionen nutzt, was er wirklich misst, warum eine Dimension fehlen kann und worin er sich vom Sichtbarkeitsindex unterscheidet.
Weil genannt werden, empfohlen werden, als Quelle zitiert werden, die Tonalität, der Vergleich mit Wettbewerbern und die Stabilität sich aus unterschiedlichen Gründen verändern. Der Wert von 0 bis 100 fasst sie zusammen, und jede bleibt mit ihrer Basis nachvollziehbar.
Nein. Niemand kann messen, was ein Modell „denkt“. Der Score fasst beobachtbare Signale in den Antworten zusammen: Erwähnungen, Empfehlungen, Quellen, Tonalität, Vergleiche und Stabilität.
Nein. Sie können an Inhalten und Quellen arbeiten und mit derselben Methode messen, was sich ändert. Niemand kann einen Anstieg versprechen.
Weil sie die Mindeststichprobe nicht erreicht hat. Sie bleibt ausgeschlossen und ausgewiesen; fällt die Abdeckung unter 70 % der Gewichte, wird kein Gesamtwert berechnet.
Der Sichtbarkeitsindex fasst die Präsenz über fünf Kanäle zusammen: KI, Suche, Social, Presse und Reputation. Der AI Trust Score betrachtet nur KI-Antworten und liest darin sechs Dimensionen. Es sind zwei getrennte, separat veröffentlichte Methoden.
Die Ihres Panels, für den Zeitraum qualifiziert und neben dem Wert ausgewiesen. Jede Kombination aus Frage und Assistent hat dasselbe Gewicht.
Weiterführende Themen
Jede Funktion beantwortet eine bestimmte Frage. Von hier gelangen Sie zu verwandten Funktionen, zur Methodik ihrer Messung und zur Hilfe für den Einsatz im Arbeitsalltag.
KI-Sichtbarkeit, AI Trust Score, Suche, Reputation, Wettbewerber, Maßnahmen und Umsetzung: eine Funktion für jede Frage zu Ihrer Marke.
LesenTrustInsider in sechs Schritten: Marke, Fragen, Kostenvoranschlag, Belege, Maßnahme pro Seite und Prüfung mit denselben Fragen.
LesenWie jede TrustInsider-Messung entsteht: Stichprobe der KI-Antworten, Quellen und Rechte, Indexberechnung und angegebene Grenzen.
LesenHilfe zu Zugang, Credits, Erhebungen, Integrationen und Daten: Anleitungen, FAQ, Website-Assistent und Support aus dem Workspace.
Lesen