Per chi decide
Un valore per periodo, con intervallo e variazione: si legge in riunione e regge le domande.
AI Trust Score
Sei segnali osservati nelle risposte degli assistenti AI, in un valore da 0 a 100: quanto ti nominano, ti consigliano, citano le tue fonti, parlano bene di te, ti preferiscono ai concorrenti e restano coerenti. Lo calcola il codice, mai un modello.
Perché un numero
Prima di scegliere, un cliente può chiedere a ChatGPT, Gemini, Perplexity, Copilot o Claude e leggere una risposta già composta. Menzioni, consigli, fonti, tono e concorrenti si muovono insieme: seguirli uno per uno è lento, presentarli a chi decide è difficile.
Il punteggio dà al team un riferimento condiviso, con il metodo pubblicato e i dettagli sempre a un clic. Non sostituisce le misure: le ordina, e indica quale segnale lavorare per primo.

Un valore per periodo, con intervallo e variazione: si legge in riunione e regge le domande.
Le dimensioni che pesano di più e quelle che frenano, con le risposte che le compongono.
Le fonti citate e le affermazioni da chiarire, collegate alle Azioni.
Le sei dimensioni
Ogni dimensione è un rapporto fra conteggi osservati, da 0 a 100, con il suo campione. I pesi sommano a 100 e cambiano solo con una nuova versione del metodo, pubblicata.
L’Autorevolezza della versione 1 misura la presenza delle tue fonti fra quelle citate; la qualità del tipo di fonte entrerà con una versione successiva. La Preferenza confronta le menzioni a coppie: 50 significa parità, qualunque sia il numero dei concorrenti.
| Dimensione e peso | Che cosa osserva | Su quale base |
|---|---|---|
| Visibilità · 25% | Quanto spesso le risposte ti nominano. | Risposte complete e revisionate, media per domanda e assistente. |
| Raccomandazioni · 20% | Quanto spesso ti consigliano per l’esigenza della domanda. | Le stesse risposte della Visibilità. |
| Autorevolezza · 15% | Quanto le risposte che espongono fonti citano le tue pagine. | Solo le risposte in cui la citazione è valutabile. |
| Reputazione · 15% | Il tono delle risposte quando ti nominano. | Menzioni positive, neutre (contate a metà) e negative. |
| Preferenza · 15% | Come ti collochi contro ciascun concorrente dichiarato. | Confronti a coppie nelle stesse risposte. |
| Coerenza · 10% | Quanto resta stabile la tua presenza fra assistenti e prove. | Solo dove compari: l’assenza è già nella Visibilità. |
Come si calcola
Il modello linguistico legge una risposta e la classifica: nomina il brand, lo consiglia, cita una sua pagina, con quale tono, accanto a quali concorrenti. Un giudice deterministico verifica ogni classificazione sul testo e una persona la revisiona. Il punteggio lo calcola il codice, solo da quei conteggi.
Il totale è la somma di peso per valore delle dimensioni misurate, divisa per la somma dei loro pesi. Stessi dati, stesso risultato, su ogni macchina.
Le stesse domande, agli stessi assistenti, a ogni ciclo.
Un estrattore classifica, un giudice deterministico controlla, una persona revisiona.
Ogni dimensione con il suo numeratore, il suo denominatore e il suo peso.
Una media pesata, con copertura e intervallo al 95% sempre accanto.
Campione e copertura
Una dimensione è misurata solo con abbastanza osservazioni. Sotto la soglia resta esclusa e dichiarata, con il motivo: non vale zero e non abbassa il totale di nascosto.
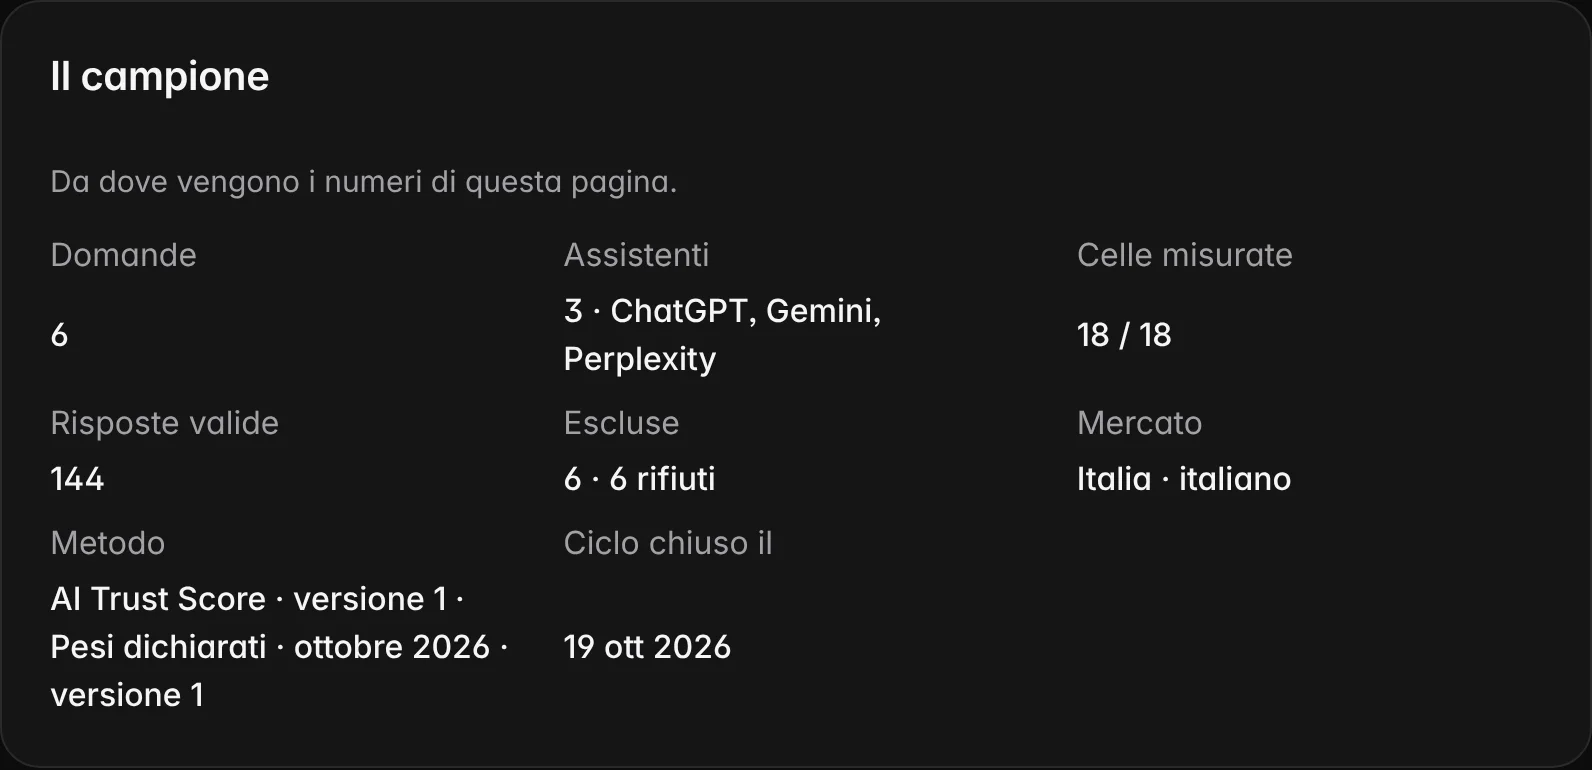
Per ogni dimensione, più un minimo di domande o di concorrenti: un solo caso non decide un valore.
La somma dei pesi misurati. Il totale esce solo se la Visibilità è misurata e la copertura arriva almeno al 70%.
Accanto al valore, l’intervallo che il totale avrebbe se le dimensioni escluse valessero 0 o 100.
Incertezza
Un punteggio senza intervallo promette una precisione che il campione non ha. Per questo accanto al valore esce sempre l’intervallo di credibilità al 95%, con la precisione dichiarata.
L’intervallo nasce da 10.000 estrazioni Monte Carlo con un seme fisso, ricampionando domande e assistenti: lo stesso panel dà lo stesso intervallo, sempre. Se la semiampiezza supera 15 punti, il valore si dichiara «oltre la soglia di precisione».
Lo stesso valore di esempio con due campioni diversi: l’intervallo stretto si confronta, quello largo si dichiara oltre la soglia di 15 punti fissata dal metodo.
| Esempio inventato | Valore e intervallo al 95% | Come si legge |
|---|---|---|
| Panel ampio | 62, fra 58 e 66: semiampiezza di 4 punti. | Precisione entro la soglia: il valore entra nei confronti. |
| Panel ridotto | 62, fra 44 e 80: semiampiezza di 18 punti. | Oltre la soglia di 15 punti: il valore esce dichiarato tale. |
| Stesso panel, di nuovo | Lo stesso intervallo, a ogni nuovo calcolo. | Il seme fisso rende ripetibili le estrazioni Monte Carlo. |
Confronti nel tempo
Ogni punteggio porta l’impronta del metodo che l’ha prodotto: versione, pesi, soglie, statistica. Due valori si mettono in fila solo con la stessa impronta; un cambio di metodo interrompe la serie invece di inventare una variazione.
Il confronto dice di quanto è cambiato il punteggio. Per attribuire un effetto servono esperimenti con un gruppo di controllo.
Lo stesso calcolo sulle risposte di un solo assistente: basi più piccole, intervalli più larghi, dichiarati.
Le sei dimensioni dei concorrenti sulle stesse domande, dove i dati lo consentono.
Dal numero all’azione
Le dimensioni che contribuiscono di più e quelle che pesano meno si leggono in punti, con la loro base. Da lì si apre la risposta che le compone e si prepara l’intervento giusto: una pagina da chiarire, una fonte da conquistare, una FAQ da scrivere.
Una lettura di esempio su un brand fittizio: la dimensione che sostiene il punteggio, quella che lo frena, la risposta da aprire e l’intervento che ne segue.
Che cosa non è
È un indicatore proprietario, con metodo pubblicato. Riassume ciò che le risposte osservate dicono di te, in un periodo, per un mercato e una lingua.
Osserva le risposte; ciò che un modello «pensa» non lo misura nessuno.
Né una previsione di vendite, né un voto ai suoi prodotti.
Nessun valore arriva da un modello linguistico: solo conteggi revisionati.
Domande frequenti
Perché l’AI Trust Score usa sei dimensioni, che cosa misura davvero, perché una dimensione può mancare e in che cosa si distingue dall’Indice di visibilità.
Perché essere nominati, essere consigliati, essere citati come fonte, il tono, il confronto con i concorrenti e la stabilità cambiano per ragioni diverse. Il valore da 0 a 100 le riassume, e ognuna resta leggibile con la sua base.
No. Nessuno può misurare che cosa «pensa» un modello. Il punteggio riassume segnali osservabili nelle risposte: menzioni, consigli, fonti, tono, confronti e stabilità.
No. Puoi lavorare su contenuti e fonti e misurare che cosa cambia, con lo stesso metodo. Nessuno può promettere un aumento.
Perché non ha raggiunto il campione minimo. Resta esclusa e dichiarata; se la copertura scende sotto il 70% dei pesi, il totale non viene calcolato.
L’Indice di visibilità riassume la presenza su cinque canali: AI, ricerca, social, stampa e reputazione. L’AI Trust Score guarda solo alle risposte AI e ne legge sei dimensioni. Sono due metodi distinti, pubblicati separatamente.
Quelli del tuo panel, qualificati nel periodo e dichiarati accanto al valore. Ogni combinazione di domanda e assistente pesa allo stesso modo.
Percorsi collegati
Ogni funzione risponde a una domanda precisa. Da qui passi alle funzioni vicine, al metodo con cui si misurano e all’aiuto per usarle nel lavoro di ogni giorno.
Visibilità AI, AI Trust Score, ricerca, reputazione, concorrenti, azioni ed esecuzione: una funzione per ogni domanda sul tuo brand.
LeggiCome funziona TrustInsider in sei passi: brand, domande, preventivo, prove, intervento pagina per pagina e verifica sulle stesse domande.
LeggiCome nasce ogni misura TrustInsider: campionamento delle risposte AI, fonti e diritti, calcolo degli indici e limiti dichiarati.
LeggiAssistenza su accesso, crediti, raccolte, integrazioni e dati: guide, FAQ, assistente del sito e richieste di supporto dal workspace.
Leggi