Pour ceux qui décident
Une valeur par période, avec intervalle et variation : elle se lit en réunion et résiste aux questions.
AI Trust Score
Six signaux observés dans les réponses des assistants IA, en une valeur de 0 à 100: à quel point ils vous nomment, vous recommandent, citent vos sources, parlent bien de vous, vous préfèrent aux concurrents et restent cohérents. C’est le code qui le calcule, jamais un modèle.
Pourquoi un chiffre
Avant de choisir, un client peut interroger ChatGPT, Gemini, Perplexity, Copilot ou Claude et lire une réponse déjà rédigée. Mentions, recommandations, sources, ton et concurrents évoluent ensemble : les suivre un par un est lent, les présenter aux décideurs est difficile.
Le score donne à l’équipe une référence partagée, avec une méthode publiée et les détails toujours à un clic. Il ne remplace pas les mesures : il les ordonne et indique quel signal travailler en premier.

Une valeur par période, avec intervalle et variation : elle se lit en réunion et résiste aux questions.
Les dimensions qui pèsent le plus et celles qui freinent, avec les réponses qui les composent.
Les sources citées et les affirmations à clarifier, reliées aux Actions.
Les six dimensions
Chaque dimension est un rapport entre comptages observés, de 0 à 100, avec son échantillon. Les poids totalisent 100 et ne changent qu’avec une nouvelle version publiée de la méthode.
L’autorité de la version 1 mesure la présence de vos sources parmi celles citées ; la qualité du type de source arrivera avec une version ultérieure. La préférence compare les mentions par paires : 50 signifie l’égalité, quel que soit le nombre de concurrents.
| Dimension et poids | Ce qu’il observe | Sur quelle base |
|---|---|---|
| Visibilité · 25 % | À quelle fréquence les réponses vous nomment. | Réponses complètes et révisées, moyenne par question et assistant. |
| Recommandations · 20 % | À quelle fréquence ils vous recommandent pour le besoin exprimé. | Les mêmes réponses que la visibilité. |
| Autorité · 15 % | À quel point les réponses qui exposent des sources citent vos pages. | Seulement les réponses où la citation est évaluable. |
| Réputation · 15 % | Le ton des réponses quand elles vous nomment. | Mentions positives, neutres (comptées à moitié) et négatives. |
| Préférence · 15 % | Votre position face à chaque concurrent déclaré. | Comparaisons par paires dans les mêmes réponses. |
| Cohérence · 10 % | La stabilité de votre présence entre assistants et essais. | Seulement là où vous apparaissez : l’absence est déjà dans la visibilité. |
Comment on le calcule
Le modèle de langage lit une réponse et la classe : nomme-t-elle la marque, la recommande-t-elle, cite-t-elle une de ses pages, avec quel ton, à côté de quels concurrents. Un juge déterministe vérifie chaque classement sur le texte et une personne le révise. Le score est calculé par le code, uniquement à partir de ces comptages.
Le total est la somme du poids multiplié par la valeur des dimensions mesurées, divisée par la somme de leurs poids. Mêmes données, même résultat, sur chaque machine.
Les mêmes questions, aux mêmes assistants, à chaque cycle.
Un extracteur classe, un juge déterministe contrôle, une personne révise.
Chaque dimension avec son numérateur, son dénominateur et son poids.
Une moyenne pondérée, toujours accompagnée de la couverture et de l’intervalle à 95 %.
Échantillon et couverture
Une dimension n’est mesurée qu’avec assez d’observations. Sous le seuil, elle reste exclue et déclarée, avec le motif : elle ne vaut pas zéro et ne fait pas baisser le total en cachette.
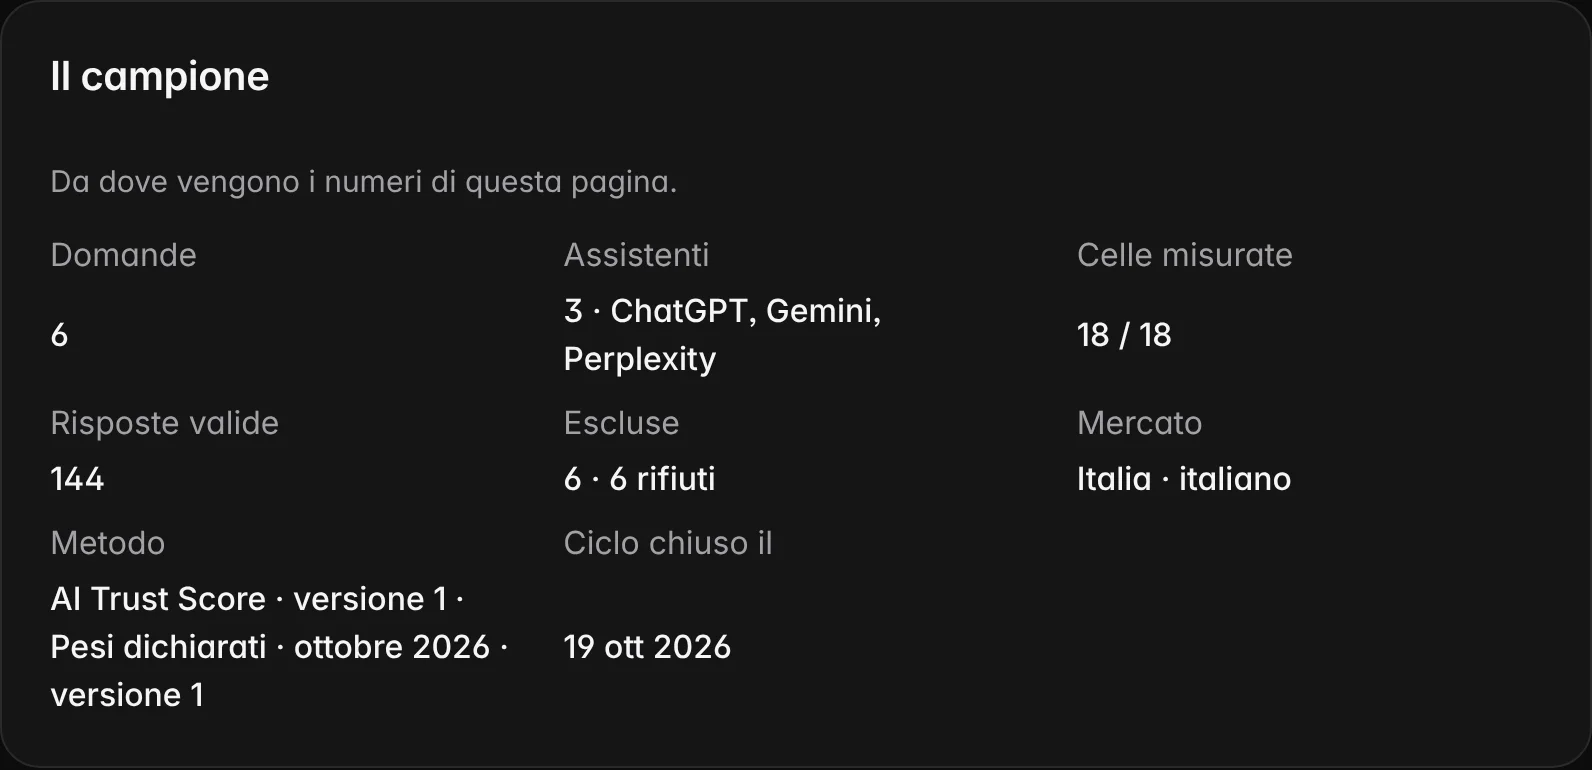
Pour chaque dimension, plus un minimum de questions ou de concurrents : un seul cas ne décide pas d’une valeur.
La somme des poids mesurés. Le total n’apparaît que si la visibilité est mesurée et que la couverture atteint au moins 70 %.
À côté de la valeur, l’intervalle qu’aurait le total si les dimensions exclues valaient 0 ou 100.
Incertitude
Un score sans intervalle promet une précision que l’échantillon n’a pas. C’est pourquoi l’intervalle de crédibilité à 95 % apparaît toujours à côté de la valeur, avec la précision déclarée.
L’intervalle provient de 10 000 tirages Monte Carlo à graine fixe, en rééchantillonnant questions et assistants : le même panel donne toujours le même intervalle. Si la demi-largeur dépasse 15 points, la valeur est déclarée « au-delà du seuil de précision ».
La même valeur d’exemple avec deux échantillons différents : l’intervalle étroit se compare, l’intervalle large est déclaré au-delà du seuil de 15 points fixé par la méthode.
| Exemple inventé | Valeur et intervalle à 95 % | Comment le lire |
|---|---|---|
| Panel large | 62, entre 58 et 66 : demi-largeur de 4 points. | Précision dans le seuil : la valeur entre dans les comparaisons. |
| Panel réduit | 62, entre 44 et 80 : demi-largeur de 18 points. | Au-delà du seuil de 15 points : la valeur est publiée avec cette mention. |
| Même panel, à nouveau | Le même intervalle, à chaque nouveau calcul. | La graine fixe rend les tirages Monte Carlo reproductibles. |
Comparaisons dans le temps
Chaque score porte l’empreinte de la méthode qui l’a produit : version, poids, seuils, statistique. Deux valeurs ne se suivent qu’avec la même empreinte ; un changement de méthode interrompt la série au lieu d’inventer une variation.
La comparaison dit de combien le score a changé. Pour attribuer un effet, il faut des expériences avec un groupe de contrôle.
Le même calcul sur les réponses d’un seul assistant : bases plus petites, intervalles plus larges, déclarés.
Les six dimensions des concurrents sur les mêmes questions, là où les données le permettent.
Du chiffre à l’action
Les dimensions qui contribuent le plus et celles qui pèsent le moins se lisent en points, avec leur base. De là, on ouvre la réponse qui les compose et on prépare la bonne action : une page à clarifier, une source à conquérir, une FAQ à écrire.
Une lecture d’exemple sur une marque fictive : la dimension qui soutient le score, celle qui le freine, la réponse à ouvrir et l’intervention qui en découle.
Ce qu’il n’est pas
C’est un indicateur propriétaire, avec une méthode publiée. Il résume ce que les réponses observées disent de vous, sur une période, pour un marché et une langue.
Il observe les réponses ; ce qu’un modèle « pense », personne ne le mesure.
Ni une prévision de ventes, ni une note attribuée à ses produits.
Aucune valeur ne vient d’un modèle de langage : seulement des comptages révisés.
Questions fréquentes
Pourquoi l’AI Trust Score utilise six dimensions, ce qu’il mesure vraiment, pourquoi une dimension peut manquer et en quoi il se distingue de l’Indice de visibilité.
Parce qu’être nommé, être recommandé, être cité comme source, le ton, la comparaison avec les concurrents et la stabilité évoluent pour des raisons différentes. La valeur de 0 à 100 les résume, et chacune reste lisible avec sa propre base.
Non. Personne ne peut mesurer ce qu’un modèle « pense ». Le score résume des signaux observables dans les réponses : mentions, recommandations, sources, ton, comparaisons et stabilité.
Non. Vous pouvez travailler sur les contenus et les sources et mesurer ce qui change, avec la même méthode. Personne ne peut promettre une hausse.
Parce qu’elle n’a pas atteint l’échantillon minimal. Elle reste exclue et déclarée ; si la couverture descend sous 70 % des poids, le total n’est pas calculé.
L’indice de visibilité résume la présence sur cinq canaux : IA, recherche, réseaux sociaux, presse et réputation. L’AI Trust Score ne regarde que les réponses IA et y lit six dimensions. Ce sont deux méthodes distinctes, publiées séparément.
Ceux de votre panel, qualifiés pour la période et déclarés à côté de la valeur. Chaque combinaison de question et d’assistant pèse autant.
Pour aller plus loin
Chaque fonctionnalité répond à une question précise. D’ici, vous passez aux fonctionnalités voisines, à la méthode qui les mesure et à l’aide pour les utiliser au quotidien.
Visibilité IA, AI Trust Score, recherche, réputation, concurrents, actions et exécution : une fonctionnalité pour chaque question sur votre marque.
LireTrustInsider en six étapes : marque, questions, devis, preuves, intervention page par page et vérification sur les mêmes questions.
LireComment naît chaque mesure TrustInsider : échantillonnage des réponses IA, sources et droits, calcul des indices et limites déclarées.
LireAide sur l’accès, les crédits, les collectes, les intégrations et les données : guides, FAQ, assistant du site et demandes de support depuis l’espace.
Lire