Entraînement
Des crawlers qui collectent des pages pour entraîner un modèle, comme GPTBot ou ClaudeBot.
Agent Analytics
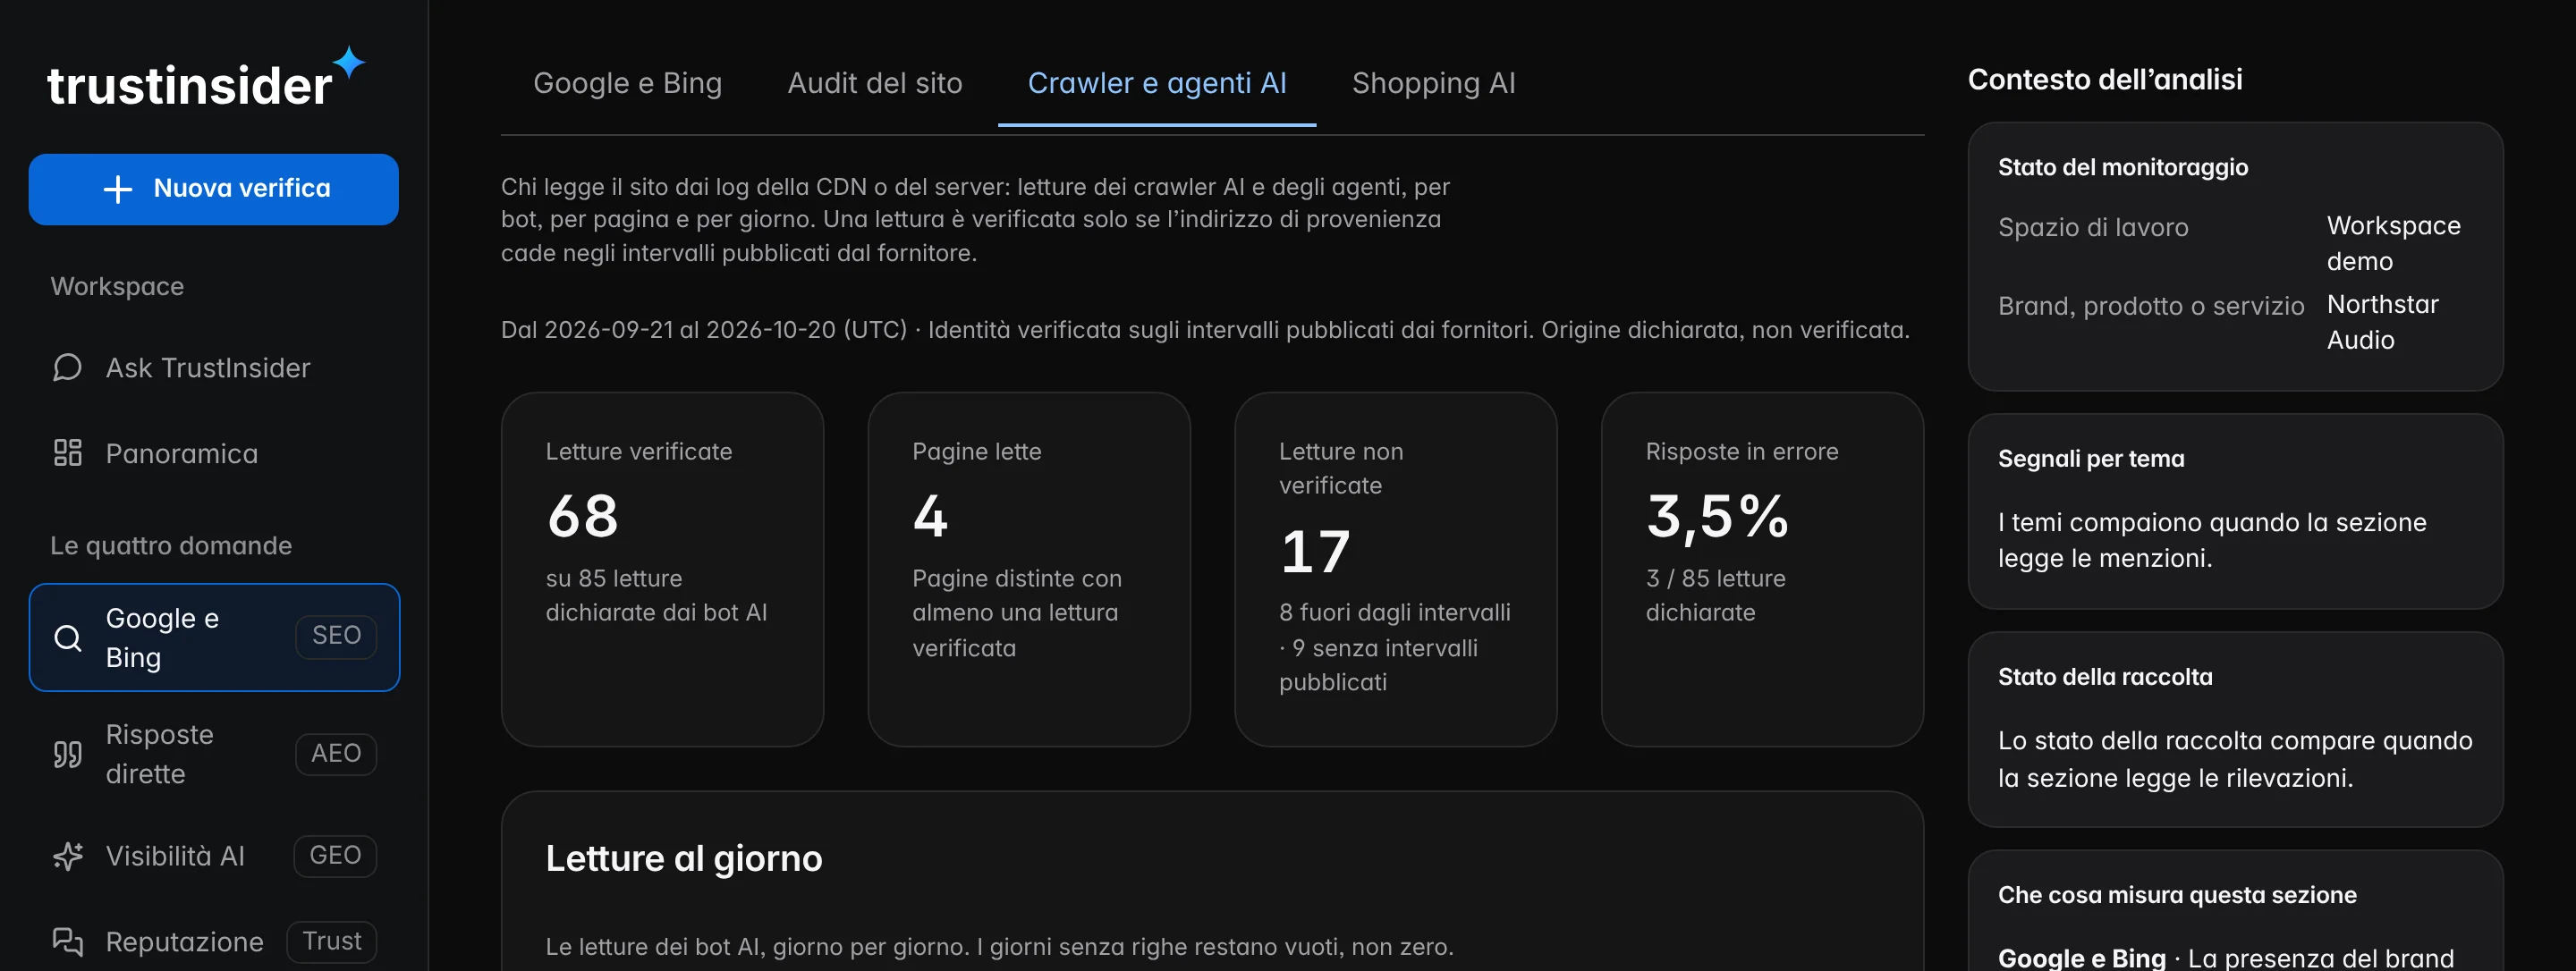
Depuis les journaux de votre site, les lectures des crawlers IA et des agents qui ouvrent vos pages pour le compte d’une personne : par bot, par page et par jour, avec l’identité vérifiée sur les plages d’adresses publiées par les fournisseurs.
Comment la recherche change
Un assistant ne peut citer une page que si quelqu’un l’a lue : un crawler qui prépare l’index, ou un agent qui l’ouvre pendant qu’une personne pose sa question. Les outils d’analyse fondés sur un script dans la page ne voient généralement pas ces lectures.

Des crawlers qui collectent des pages pour entraîner un modèle, comme GPTBot ou ClaudeBot.
Des crawlers qui préparent l’index à partir duquel l’assistant cite, comme OAI-SearchBot ou PerplexityBot.
Des agents qui ouvrent la page pendant que quelqu’un parle avec l’assistant, comme ChatGPT-User ou Perplexity-User.
Vérifié ou déclaré
N’importe qui peut écrire « GPTBot ». Une lecture ne compte comme vérifiée que si l’adresse d’origine tombe dans les plages publiées par le fournisseur. Qui ne les publie pas reste « déclaré » : jamais vérifié, jamais inventé.
| Fournisseur | Agents | Vérification de l’identité |
|---|---|---|
| OpenAI | GPTBot · OAI-SearchBot · ChatGPT-User | Plages d’adresses publiées par le fournisseur |
| Perplexity | PerplexityBot · Perplexity-User | Plages d’adresses publiées par le fournisseur |
| Anthropic | ClaudeBot · Claude-SearchBot · Claude-User | Aucune plage publiée : lecture déclarée |
| Google et Microsoft | Googlebot · Bingbot | Plages publiées ; moteurs de recherche, sans intention IA séparable |
Quatre mesures
Chaque page a quatre mesures, chacune avec sa source. Elles restent séparées parce qu’elles répondent à des questions différentes : une page peut être accessible et non lue, lue et non citée, citée et non visitée.
La page répond et n’est pas exclue : l’audit du site le dit.
Les agents l’ont ouverte, par intention : les journaux le disent.
Les réponses de l’IA l’indiquent comme source : les relevés le disent.
Des personnes arrivées depuis un assistant : Google Analytics 4 le dit.
Ce que vous voyez
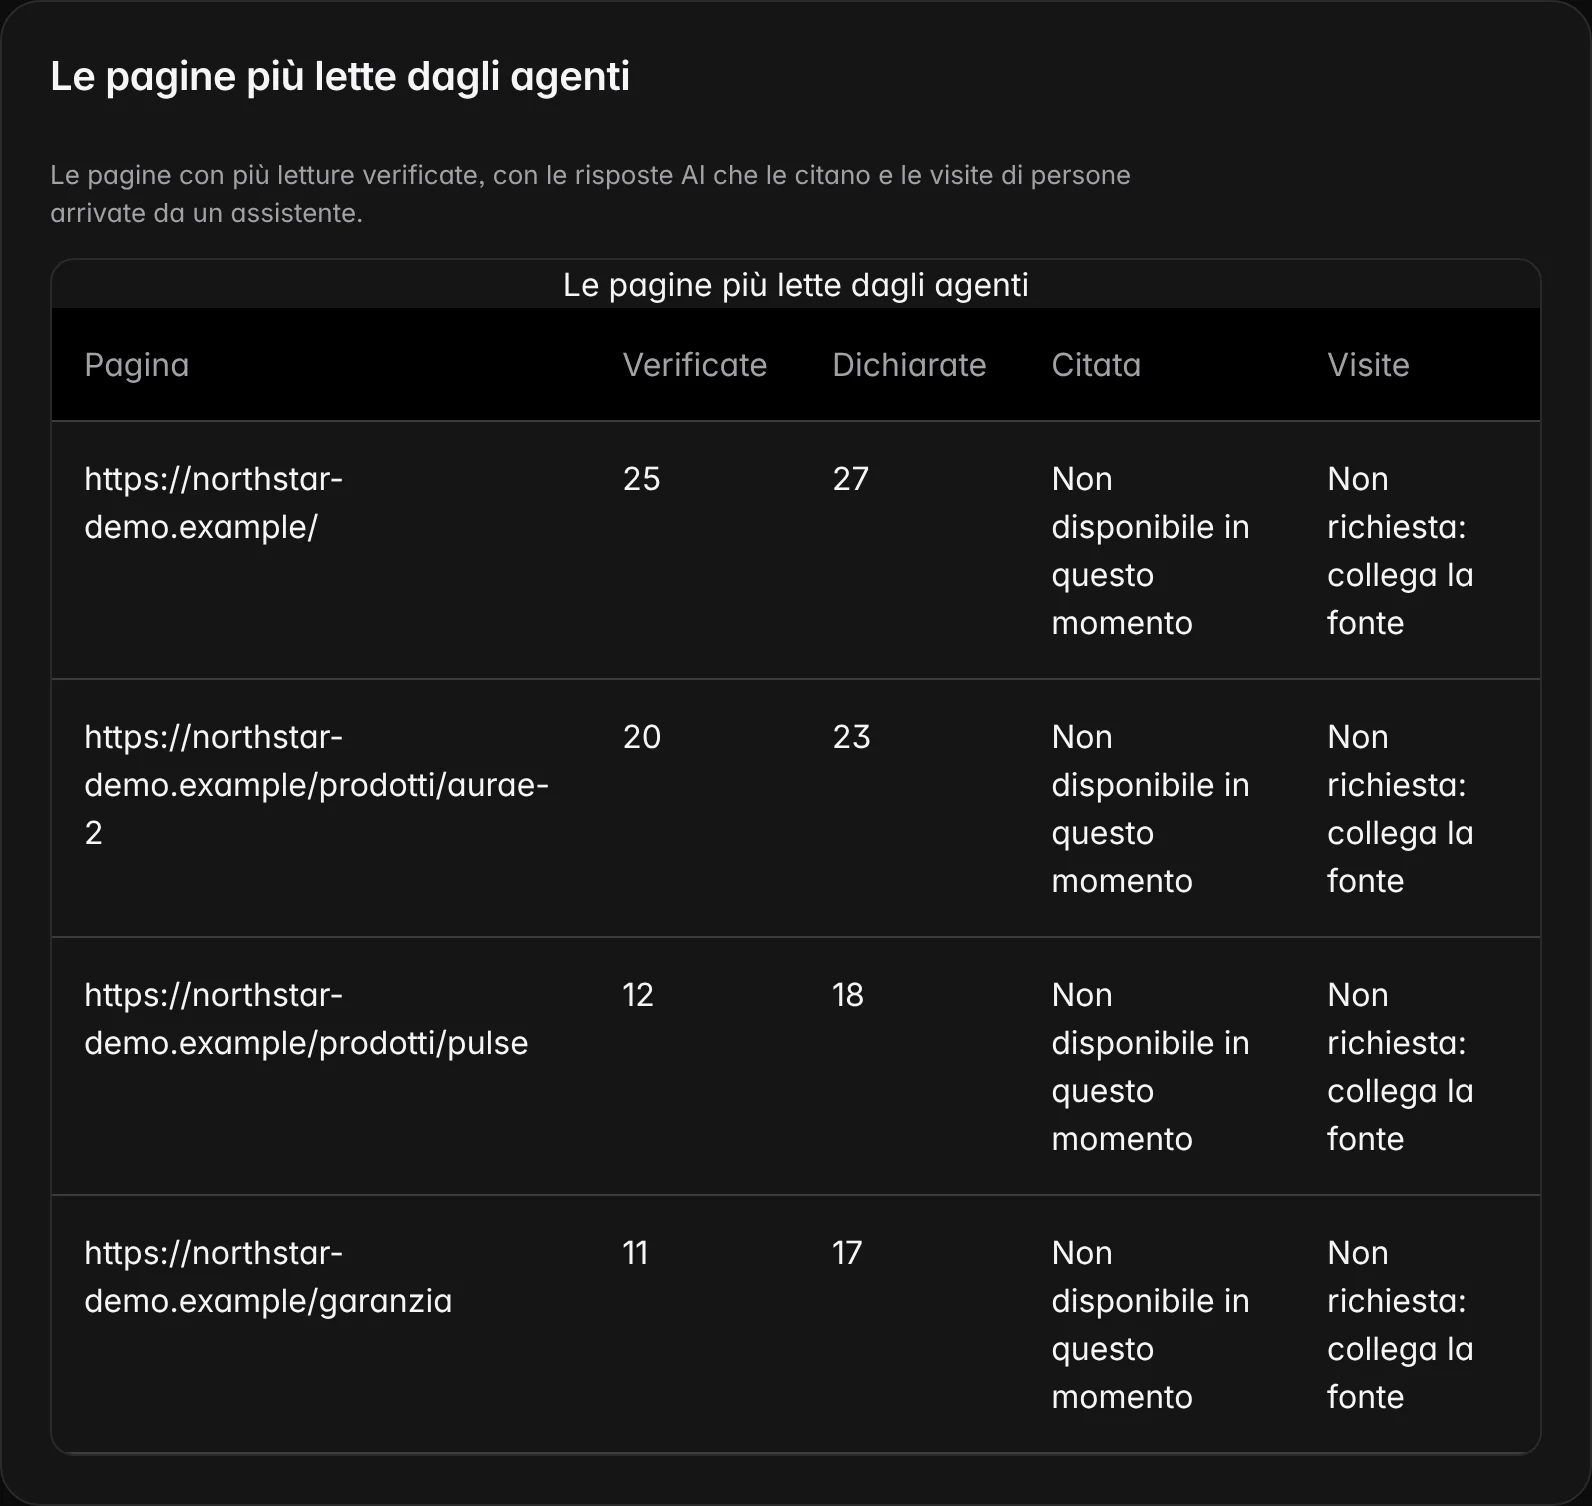
Les lectures se suivent dans le temps et se croisent avec l’audit, avec les réponses qui citent les pages et avec les visites depuis les assistants. Vous voyez aussi les erreurs renvoyées aux agents, comme les pages manquantes et les délais dépassés, et qui respecte robots.txt.
Les journaux, et la confidentialité
C’est vous qui autorisez les journaux. La vérification et l’agrégation ont lieu avant tout enregistrement : il ne reste que les comptages par jour, page et bot.
Cloudflare Logpush vers notre adresse, ou un flux NDJSON depuis un autre CDN.
L’adresse d’origine est comparée aux plages publiées par le fournisseur du bot.
Adresses et user-agents restent en mémoire le temps de l’agrégation : seuls les comptages sont enregistrés.
Les agrégats expirent après 30 jours et sont supprimés.
Questions fréquentes
Ce que sont les robots d’exploration IA, pourquoi Google Analytics n’affiche pas leurs lectures, comment nous vérifions qu’une lecture vient vraiment de qui elle prétend et ce qu’il faut installer.
Des programmes qui lisent les pages du web pour le compte d’un service d’intelligence artificielle : pour entraîner un modèle, préparer l’index à partir duquel l’assistant cite, ou ouvrir une page pendant qu’une personne pose sa question.
Parce que les crawlers n’exécutent généralement pas le script d’analyse de la page. Leurs requêtes apparaissent dans les journaux du serveur ou du CDN, et c’est là que nous les lisons.
Nous comparons l’adresse d’origine aux plages publiées par le fournisseur. Si elle ne correspond pas, la lecture reste « non vérifiée » et n’entre pas parmi les pages lues.
Non. Aucun script dans les pages : on connecte le CDN en lecture seule, ou on envoie un flux de journaux.
Pour aller plus loin
Chaque fonctionnalité répond à une question précise. D’ici, vous passez aux fonctionnalités voisines, à la méthode qui les mesure et à l’aide pour les utiliser au quotidien.
Visibilité IA, AI Trust Score, recherche, réputation, concurrents, actions et exécution : une fonctionnalité pour chaque question sur votre marque.
LireTrustInsider en six étapes : marque, questions, devis, preuves, intervention page par page et vérification sur les mêmes questions.
LireComment naît chaque mesure TrustInsider : échantillonnage des réponses IA, sources et droits, calcul des indices et limites déclarées.
LireAide sur l’accès, les crédits, les collectes, les intégrations et les données : guides, FAQ, assistant du site et demandes de support depuis l’espace.
Lire